最近本機 AI 影片最讓我意外的,不只是畫質進步,而是「影片、中文對話、嘴型、音效、背景音樂」開始可以在同一個模型裡一起生成。MiniMax H3 開放權重之後,ComfyUI 很快就提供原生支援;再搭配 Director 類型的多段 Timeline 工作流,原本每次最多約 15 秒的片段,也能透過多段生成、接續與輸出串成較長影片,實際上更接近一套可以反覆調整的 AI 影片工作台。
這篇文章從完全沒有 ComfyUI 經驗的角度開始,整理我目前實際使用 MiniMax H3 時最容易混淆的幾個概念:ComfyUI 是什麼、Workflow 到底是什麼、Hugging Face 的模型要下載哪幾顆、FL2VA 和 Ref2VA 差在哪、UNET/CLIP/LoRA/VAE 各自負責什麼,以及在 RTX 5070 12GB VRAM + 32GB RAM 這種並不算誇張的硬體上,怎麼做出比較實際的配置。
閱讀建議:第一~六章是「從零開始的安裝與設定」:準備軟體、安裝 ComfyUI、安裝 Custom Node、下載模型、放進正確資料夾、載入 Workflow 試跑。照順序做完,就能跑出第一支影片。第七章之後才是原理、參數與進階技巧,遇到不懂的地方再回頭查就好。
文章目錄
第一部分:從零開始安裝與設定
- 安裝前準備:需要哪些軟體與硬體?
- 安裝與更新 ComfyUI(Windows Portable)
- 安裝 Custom Node:MiniMax H3 Director
- 下載模型檔:要抓哪幾顆、怎麼抓
- 模型檔要放進哪個資料夾?
- 載入 Workflow,跑第一次測試
第二部分:原理、參數與進階技巧
- 為什麼是 ComfyUI + MiniMax H3?
- ComfyUI 與 Workflow 是什麼?
- MiniMax H3 在紅什麼?
- UNET:FL2VA、Ref2VA、bf16 與 INT8 差在哪、W4A8
- CLIP/Text Encoder:三顆 Qwen 怎麼選?
- Video VAE 與 Audio VAE
- Turbo LoRA:為什麼加速、代價與本文實際設定
- Director 有什麼特色?Workflow 使用重點
- Director Sampling:Steps、Sampler、Scheduler、Shift
- 如何突破單次 15 秒限制?
- 用 AI 幫每一段寫 Prompt
- 人物臉部一致性:多角度 Reference、構圖與後製
- RTX 5070 12GB + 32GB RAM 最佳化、OOM 與 –reserve-vram
- 常見問題與排查
一、安裝前準備:需要哪些軟體與硬體?
正式動手前,先確認電腦符合需求,並把需要的免費軟體裝好。這一章只要做一次。
| 項目 | 需求 | 說明 |
|---|---|---|
| 作業系統 | Windows 10 / 11(64 位元) | 本文以 Windows 示範 |
| 顯示卡 | NVIDIA RTX 顯卡 | 本文實測環境是 RTX 5070 12GB VRAM |
| 記憶體 | 32GB RAM(本文環境) | H3 的模型加起來超過 36GB,12GB 顯卡放不下,ComfyUI 會把一部分搬到 RAM;記憶體更少會很吃力 |
| 硬碟空間 | 建議預留 70GB 以上,最好是 SSD | 模型檔約 44.5GB,再加上 ComfyUI 本體、暫存與輸出影片 |
| Git(必裝) | 免費 | 到 git-scm.com 下載安裝,一路按 Next 即可。裝完開啟終端機輸入 git --version,看到版本號碼就成功。第三章安裝 Custom Node 會用到 |
| 7-Zip(必裝) | 免費 | ComfyUI Portable 是 .7z 壓縮檔,Windows 內建的解壓縮不一定能開,請到 7-zip.org 下載 |
| Python(選用) | 免費 | ComfyUI Portable 自己內建一套 Python,所以不需要另外安裝。只有第四章想用 hf 指令下載模型時才需要;用瀏覽器下載就可以略過 |
安裝流程總覽:
1. 準備 Git、7-Zip
2. 下載並解壓縮 ComfyUI Portable,更新到最新版
3. 安裝 Custom Node:MiniMax H3 Director
4. 下載 5 個模型檔(約 44.5 GB)
5. 把模型檔放進 models 底下對應的資料夾
6. 載入 Workflow,確認各個模型載入節點,跑第一次測試二、安裝與更新 ComfyUI(Windows Portable)
ComfyUI 官方目前對一般新手優先推薦 Desktop 版;不過如果你想清楚掌握模型資料夾、Python、Custom Nodes 與備份,我仍然很喜歡 Windows Portable:整個程式就是一個資料夾,想備份、搬家、刪除都很直覺。本文以下用 Portable 示範。
1. 下載
到 ComfyUI Releases,在最新版本的 Assets 清單中下載 NVIDIA 顯卡用的 Windows Portable,檔名是 ComfyUI_windows_portable_nvidia.7z。RTX 50 系列請選這個標準版;檔名帶有 cu126 的是給較舊環境的備用版。
2. 解壓縮
用 7-Zip 解壓縮。建議放在 C:\AI\ 這種簡短的位置,路徑不要有中文或空格,也不要放在桌面、OneDrive 或「下載」資料夾,之後比較不容易出問題。解壓縮後的結構如下:
ComfyUI_windows_portable\
├─ ComfyUI\            ← 本文說的「ComfyUI 資料夾」,模型、custom_nodes 都放在這裡面
├─ python_embeded\     ← ComfyUI 自帶的 Python
├─ update\             ← 更新用的 bat 檔
└─ run_nvidia_gpu.bat ← 啟動 ComfyUI關於路徑的說明:以下範例假設把整個 ComfyUI_windows_portable 資料夾放在 C:\AI\,所以模型與第三方節點都在 C:\AI\ComfyUI_windows_portable\ComfyUI\ 底下。若你的解壓位置不同,請替換路徑前綴;不要把模型放在外層資料夾。
3. 第一次啟動
連點兩下 run_nvidia_gpu.bat,會跳出黑色視窗並開始載入,瀏覽器通常會自動打開 http://127.0.0.1:8188。看到節點畫布,就代表 ComfyUI 本身可以運作。接著回到黑色視窗按 Ctrl + C(或直接關閉視窗)先結束它,我們要先更新。
4. 更新 ComfyUI
MiniMax H3 是 2026 年才加入的原生功能,官方支援從 v0.30.0 起加入,所以舊版 ComfyUI 一定跑不了。請連點兩下 update\update_comfyui.bat,等視窗跑完(最後會要你按任意鍵)就更新完成了。更新後再啟動一次,從設定(齒輪)→ About 可以看到版本號碼。
之後如果看到 Workflow 裡的 H3 節點全部變紅,第一件事不是亂裝 Custom Node,而是先回來更新 ComfyUI。
5. Manager(選用)
新版 Desktop 已內建 Manager;Portable 的 Manager 也已進核心,但可能需要安裝 manager requirements 並用 --enable-manager 啟動。Manager 可以用圖形介面安裝第三方節點,但本文不依賴它:下一章直接用指令安裝,步驟最清楚,也最不容易出錯。
Desktop 版使用者:資料夾名稱(models、custom_nodes)與上面相同,但位置在安裝時所選的資料目錄底下;下一章的 pip 指令也不能照抄,建議改用 Manager 的 Install via Git URL 安裝。
三、安裝 Custom Node:MiniMax H3 Director
Director 是 ComfyUI 的「Custom Node(第三方節點)」,後面的 Workflow 靠它做多段影片。安裝方式很單純:把它的 GitHub 專案下載到 ComfyUI 的 custom_nodes 資料夾,再安裝它需要的 Python 套件。多數 Custom Node 也能依照這個基本流程安裝,但仍要看各專案的安裝說明。前提是電腦已經裝好 Git(第一章)。
- 在檔案總管中打開 ComfyUI 資料夾裡的
custom_nodes(例如C:\AI\ComfyUI_windows_portable\ComfyUI\custom_nodes)。 - 在資料夾的空白處按滑鼠右鍵,選「在終端機開啟」。這樣終端機的目前位置就剛好在
custom_nodes裡面。(Windows 10 沒有這個選項:點一下檔案總管上方的網址列,輸入cmd再按 Enter,效果一樣。) - 在終端機內貼上第一行指令,按 Enter,等它跑完(下載 Director):
git clone https://github.com/AIMixer/ComfyUI_MiniMaxH3_Director.git- 再貼上第二行,按 Enter,安裝 Director 需要的 Python 套件(第一次可能要跑幾分鐘,請耐心等它出現新的輸入提示再繼續):
..\..\python_embeded\python.exe -m pip install -r ComfyUI_MiniMaxH3_Director\requirements.txt- 關閉並重新啟動 ComfyUI(
run_nvidia_gpu.bat)。在畫布空白處連點滑鼠兩下打開搜尋框,輸入MiniMax H3 Director,找得到節點就代表安裝成功。
為什麼第二行不是官方寫的 pip install -r ...?官方 README 寫的是一般的 pip install -r ComfyUI_MiniMaxH3_Director/requirements.txt,這行可能把套件裝進系統 Python,而不是 Portable 內建的 Python。但 Portable 的 ComfyUI 用的是自己的 python_embeded,套件裝錯地方,ComfyUI 就讀不到,Director 會載入失敗。所以 Portable 要改用上面這行,指定用 ComfyUI 自帶的 Python 來安裝。..\..\python_embeded 的意思是從 custom_nodes 往上兩層,回到 ComfyUI_windows_portable。如果你不是用 Portable,而是自己用虛擬環境(venv)安裝的 ComfyUI,才直接使用官方的 pip install -r 指令(要在同一個虛擬環境裡執行)。
以後要裝其他的 Custom Node,做法完全一樣:切到 custom_nodes、右鍵「在終端機開啟」,到那個節點的 GitHub 頁面複製 git clone 網址貼上;如果專案裡有 requirements.txt,再用 ..\..\python_embeded\python.exe -m pip install -r 資料夾名稱\requirements.txt 安裝套件;最後重新啟動 ComfyUI。
四、下載模型檔:要抓哪幾顆、怎麼抓
MiniMax H3 不是「一顆 checkpoint 丟進去就好」的模型。它至少分成主模型(Diffusion Model)、文字編碼器(Text Encoder)、Video VAE、Audio VAE;要加速再多一顆 Turbo LoRA。這些檔案都放在 Hugging Face,你可以把它當成「模型版的 GitHub」:先看 Model Card,再看 Files,需要哪一顆就下載哪一顆。不要看到整個 Repo 就全部抓回來,同一個 Repo 裡有好幾種精度版本,全部抓會是幾百 GB。
本文使用的 5 個檔案(R2V:參考圖生影片)
| 檔案 | 大小 | 放進哪個資料夾(ComfyUI\models\ 底下) |
下載來源 |
|---|---|---|---|
minimax_h3_ref2va_pruned_int8_convrot.safetensors |
約 21 GB | diffusion_models |
Comfy-Org / MiniMax-H3 |
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
約 15.7 GB | text_encoders |
Comfy-Org / MiniMax-H3 |
minimax_h3_video_vae_fp16.safetensors |
約 5.2 GB | vae |
Comfy-Org / MiniMax-H3 |
minimax_h3_audio_vae_fp32.safetensors |
約 0.6 GB | vae |
Comfy-Org / MiniMax-H3 |
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors |
約 2 GB | loras |
lightx2v / Minimax-h3-Turbo |
合計約 44.5 GB。如果你還想使用「首尾幀生影片(FL2V)」模式,請再加下載下方「FL2V 要多下載的 2 個檔案」,合計再多約 23 GB。FL2VA 與 Ref2VA 的差別、INT8 與 W4A8 怎麼選,第十章有詳細說明;第一次安裝先照上表下載就好。
FL2V(首尾幀生影片)要多下載的 2 個檔案
FL2V 的用法是指定「起始幀」與「結束幀」,中間的動作由模型補出來。它和 R2V 的差別在於主模型與加速 LoRA 都要換成 FL2V 專用版本,其餘 3 個檔案(文字編碼器、Video VAE、Audio VAE)兩種模式共用,不必重複下載。
| 檔案 | 大小 | 放進哪個資料夾(ComfyUI\models\ 底下) |
下載來源 |
|---|---|---|---|
minimax_h3_fl2va_pruned_int8_convrot.safetensors(FL2V 主模型) |
約 21 GB(20.97 GB) | diffusion_models |
Comfy-Org / MiniMax-H3 |
minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors(FL2V 8 步加速 LoRA) |
約 1.96 GB | loras |
lightx2v / Minimax-h3-Turbo |
配對規則:FL2VA 主模型搭配 FL2V Turbo LoRA,Ref2VA 主模型搭配 Ref2V Turbo LoRA,不要交叉使用。同一個 LoRA Repo 裡還有 4 步版、帶 _768p 的版本與非 ComfyUI 版(沒有 _comfyui 的檔名),挑檔案時請認準上表的完整檔名,以及 _comfyui_bf16 結尾的 ComfyUI 版。要看全部檔案可到 Files and versions。
其他來源(進階用,第一次可以不看):Kijai / MiniMax-H3-experimental 提供實驗性 W4A8 等低記憶體版本;AIMixer / ComfyUI_MiniMaxH3_Director 就是第三章安裝的 Director。
方法 A:用瀏覽器下載(最簡單,不用裝任何東西)
- 點上表的下載來源連結,進入該 Repo 的檔案頁面。
- 點進檔案所在的資料夾(例如
diffusion_models),再點你要的檔名。 - 在檔案頁面按「download」(向下箭頭圖示),瀏覽器就會開始下載。
- 下載完成後,把檔案搬到上表指定的資料夾(第五章會再確認一次位置)。
注意:檔案很大,瀏覽器下載途中如果斷線,常常得整個重來。網路不穩的話,建議改用方法 B。
方法 B:用 hf 指令下載(可續傳,可直接下載到正確資料夾)
這個方法需要系統版 Python:到 python.org 下載安裝,安裝畫面最下面務必勾選「Add python.exe to PATH」。裝好後開啟終端機(在哪個資料夾開都可以),先安裝 Hugging Face 的命令列工具:
pip install -U huggingface_hub接著依序貼上下面五行,每行一個指令,貼一行、按一次 Enter、等它下載完再貼下一行。--local-dir 後面請換成你自己的 models 資料夾位置;指令會自動把檔案放進對應的子資料夾。
hf download Comfy-Org/MiniMax-H3 diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors --local-dir C:\AI\ComfyUI_windows_portable\ComfyUI\modelshf download Comfy-Org/MiniMax-H3 text_encoders/qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors --local-dir C:\AI\ComfyUI_windows_portable\ComfyUI\modelshf download Comfy-Org/MiniMax-H3 vae/minimax_h3_video_vae_fp16.safetensors --local-dir C:\AI\ComfyUI_windows_portable\ComfyUI\modelshf download Comfy-Org/MiniMax-H3 vae/minimax_h3_audio_vae_fp32.safetensors --local-dir C:\AI\ComfyUI_windows_portable\ComfyUI\modelshf download lightx2v/Minimax-h3-Turbo minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors --local-dir C:\AI\ComfyUI_windows_portable\ComfyUI\models\loras要用 FL2V(首尾幀)的話,再多貼這兩行(FL2V 主模型約 21 GB、加速 LoRA 約 1.96 GB):
hf download Comfy-Org/MiniMax-H3 diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors --local-dir C:\AI\ComfyUI_windows_portable\ComfyUI\modelshf download lightx2v/Minimax-h3-Turbo minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors --local-dir C:\AI\ComfyUI_windows_portable\ComfyUI\models\loras如果下載中斷,重新執行同一行指令就會接續下載。如果終端機說找不到 hf,先把終端機關掉重開;還是不行就改用方法 A。
選檔案的小技巧:LoRA 檔名有 _comfyui_bf16 時,優先選 ComfyUI 版本,不要把同一顆 LoRA 的 Diffusers 版和 ComfyUI 版都下載。
五、模型檔要放進哪個資料夾?
五個檔案下載好之後,請確認它們位在 ComfyUI 資料夾的下面這些位置。放錯資料夾是新手最常遇到的問題:ComfyUI 的下拉選單只會列出「放在正確資料夾裡」的檔案。
C:\AI\ComfyUI_windows_portable\ComfyUI\
├─ models\
│  ├─ diffusion_models\
│  │  ├─ minimax_h3_ref2va_pruned_int8_convrot.safetensors   ← R2V 主模型
│  │  └─ minimax_h3_fl2va_pruned_int8_convrot.safetensors    ← FL2V 主模型(要用首尾幀才需要)
│  ├─ text_encoders\
│  │  └─ qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
│  ├─ vae\
│  │  ├─ minimax_h3_video_vae_fp16.safetensors
│  │  └─ minimax_h3_audio_vae_fp32.safetensors
│  └─ loras\
│     ├─ minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors   ← R2V 加速 LoRA
│     └─ minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors         ← FL2V 加速 LoRA(要用首尾幀才需要)
├─ custom_nodes\
│  └─ ComfyUI_MiniMaxH3_Director\      ← 第三章 git clone 出來的
├─ user\default\workflows\             ← 放 Workflow JSON(第六章)
├─ input\
└─ output\                             ← 生成的影片會在這裡
Comfy-Org 的 MiniMax H3 Model Card 也列出相同的資料夾結構。放完檔案後有三個重點:
- 不要放進
checkpoints。H3 的主模型要放diffusion_models,文字編碼器要放text_encoders,這和舊式 Stable Diffusion 的習慣不同。 - 兩顆 VAE 都放在
vae。Video VAE 與 Audio VAE 缺一不可(第十二章說明)。 - 如果 ComfyUI 在你放檔案時已經開著,請重新整理瀏覽器頁面(或重新啟動 ComfyUI),下拉選單才會看到新檔案。
六、載入 Workflow,跑第一次測試
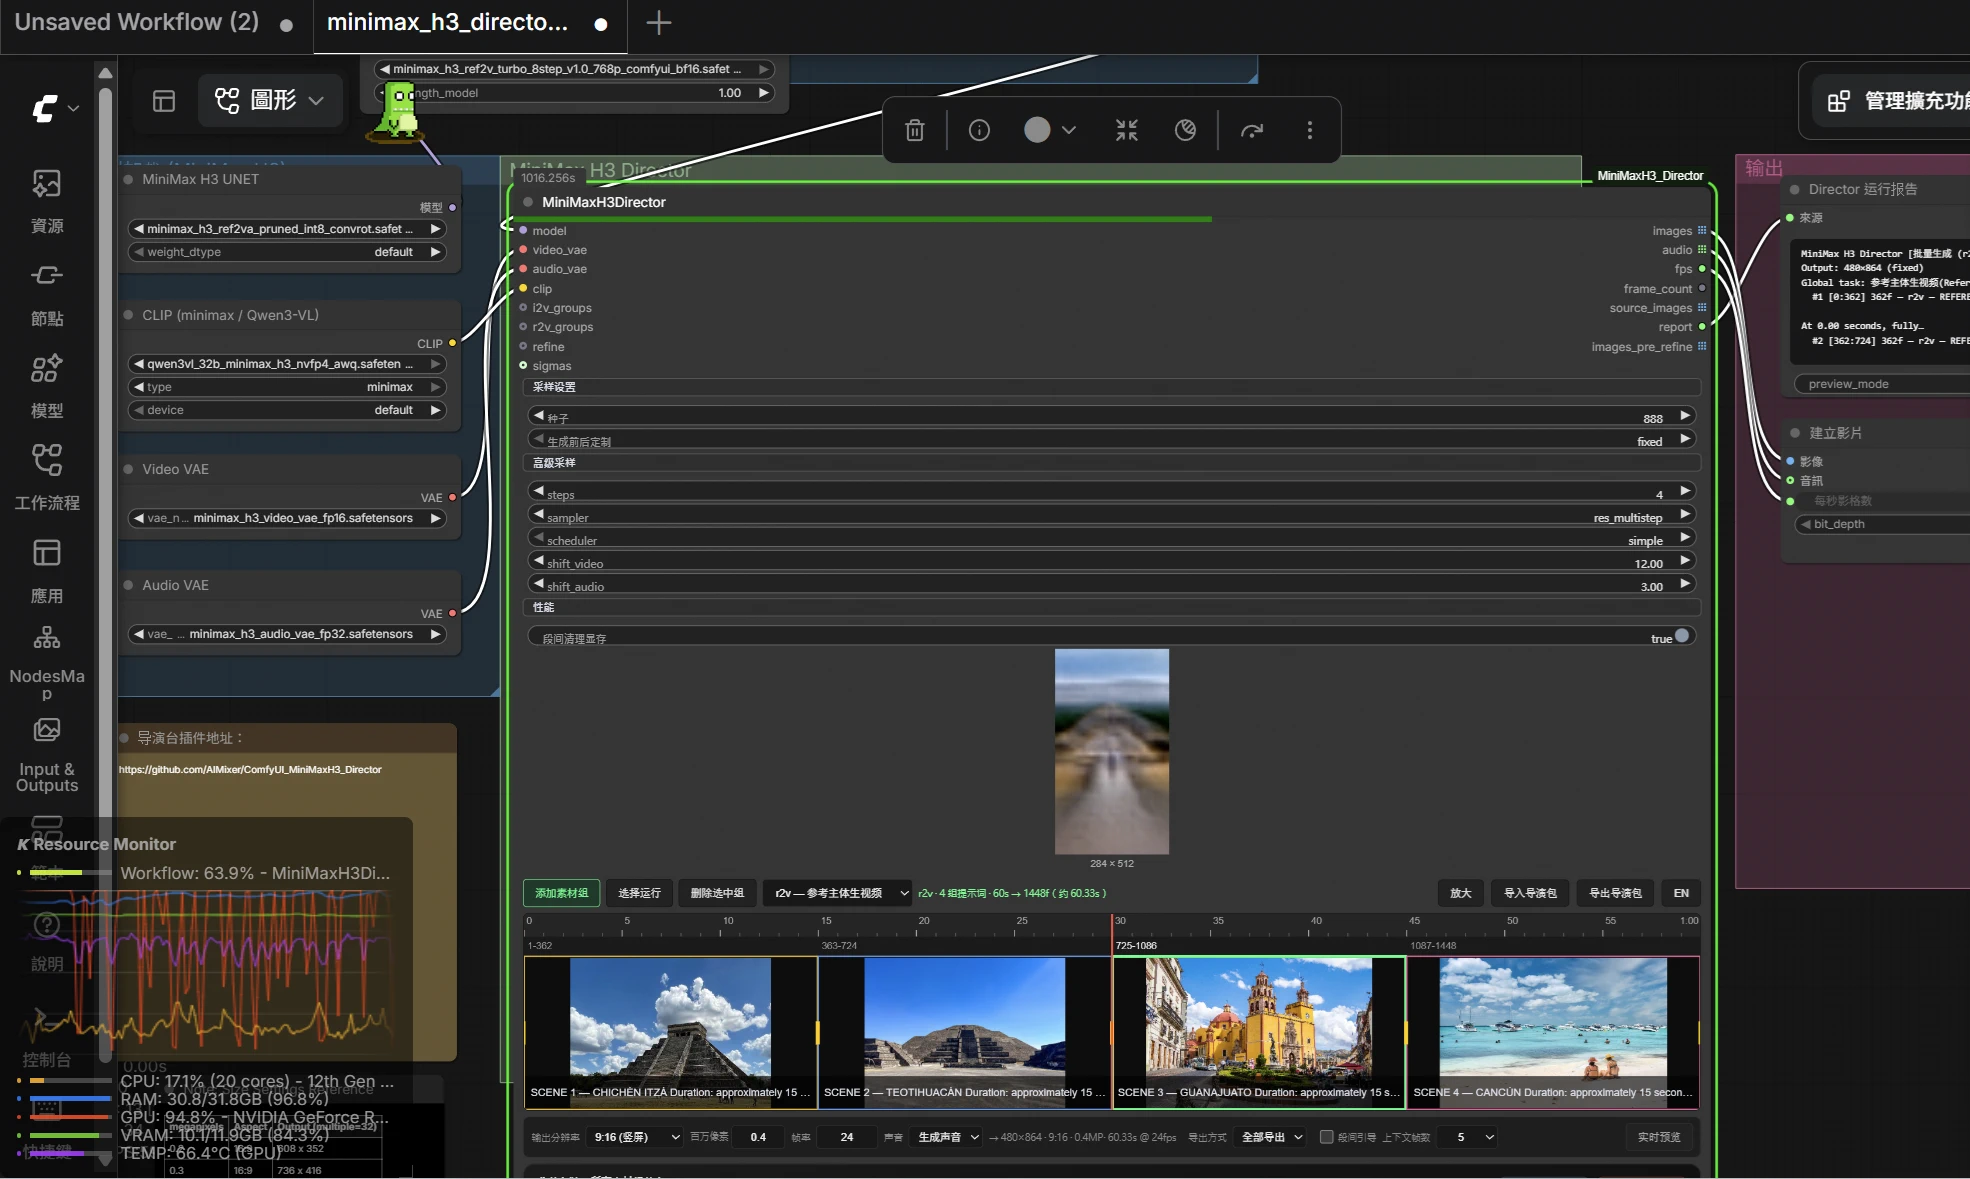
前面五章把「環境」都裝好了,現在要載入 Workflow(節點接線圖),讓 ComfyUI 知道要怎麼用這些模型。我整理了一份 Director 加速版修正 Workflow,放在 Google Drive:
下載資料夾:MiniMax H3 Director 加速版修正 Workflow
資料夾裡有兩份 Workflow,依你要做的事選對應的檔案:
minimax_h3_director_fl2v_可自選LoRA.json— 首尾幀生 Video(Fl2V:指定起始幀與結束幀,中間畫面由模型補間生成)minimax_h3_director_r2v_可自選LoRA.json— 參考圖生 Video(R2V:用參考圖(人物、場景,也可加影片、音訊)維持角色/場景一致性)
1. 載入 Workflow
下載後,直接把 JSON 檔拖進 ComfyUI 的畫布就會載入;也可以用 Workflow → Open 開啟。如果希望它永久出現在左側的 Workflow 清單,把檔案放進 C:\AI\ComfyUI_windows_portable\ComfyUI\user\default\workflows\(路徑請換成你自己的 ComfyUI 資料夾)。第一次載入如果有節點是紅色的,請看下方「排查」。
2. 逐一確認模型載入節點
Workflow 檔案只記錄「檔名」,所以要確認每個載入節點的下拉選單都選到你剛剛下載的檔案:
- 主模型:
minimax_h3_ref2va_pruned_int8_convrot.safetensors(R2V Workflow);FL2V Workflow 則選minimax_h3_fl2va_pruned_int8_convrot.safetensors。 - 文字編碼器(CLIP):
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors,而且載入節點的 type 必須選minimax,選錯會報錯或結果異常。 - Video VAE:
minimax_h3_video_vae_fp16.safetensors。 - Audio VAE:
minimax_h3_audio_vae_fp32.safetensors。 - Turbo LoRA:
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors(R2V Workflow);FL2V Workflow 則選minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors。strength 都是1.0。
如果某個下拉選單是空的,或選不到檔案,就是檔案放錯資料夾,或是放完之後還沒重新整理(回到第五章檢查)。
R2V 試跑前再檢查:參考圖的 Ref image size 使用 match,每個 Segment 都要確認,不要直接用 max。依這次本機製作的觀察,這個選項會大幅影響生成時間;完整說明見第十四章的參考圖尺寸設定。
3. 第一次先跑一小段
這兩份都改成可自選 LoRA,不再寫死單一 Turbo LoRA;R2V 預設使用 Ref2VA INT8 + Ref2V Turbo 8-step v1.0 768p,FL2V 預設使用 FL2VA INT8 + FL2V Turbo 8-step v1.0,Director Sampling 設定為 steps = 8、sampler = res_multistep、scheduler = simple、shift_video = 12、shift_audio = 3,並啟用段間清理顯存。第一次使用建議先只跑一個 5–10 秒的 Segment,確認主模型、Qwen3-VL、Video VAE、Audio VAE 與所選 LoRA 都能正常載入,再開始增加多段。
按下 Run 之後,第一次會花比較久:ComfyUI 要把約 40GB 的模型從硬碟讀進來,並在顯卡與記憶體之間搬動,這是正常的。生成好的影片會存在 ComfyUI\output\。
↑ 回到目錄
七、為什麼是 ComfyUI + MiniMax H3?
如果只是想按一個按鈕生影片,線上 AI 服務通常比較簡單;但一旦開始在意人物一致性、模型版本、解析度、參考圖、LoRA、取樣步數、長影片接續,或想要把同一套流程重複跑很多次,ComfyUI 的優勢就會出現。
MiniMax H3 則剛好補上了本機影片工作流裡很重要的一塊:它不是單純「畫面模型」,而是能理解文字、圖片、影片與音訊參照,並原生生成帶立體聲音訊的影片。官方開放權重版本支援 4–15 秒、24 FPS,中文也列在穩定支援的對話語言中。對需要中文旁白、主持人口播、角色聲音與現場音效的人來說,這點非常實用。
參考:MiniMax H3 Open Source、MiniMaxAI / MiniMax-H3。
↑ 回到目錄
八、ComfyUI 是什麼?Workflow 又是什麼?
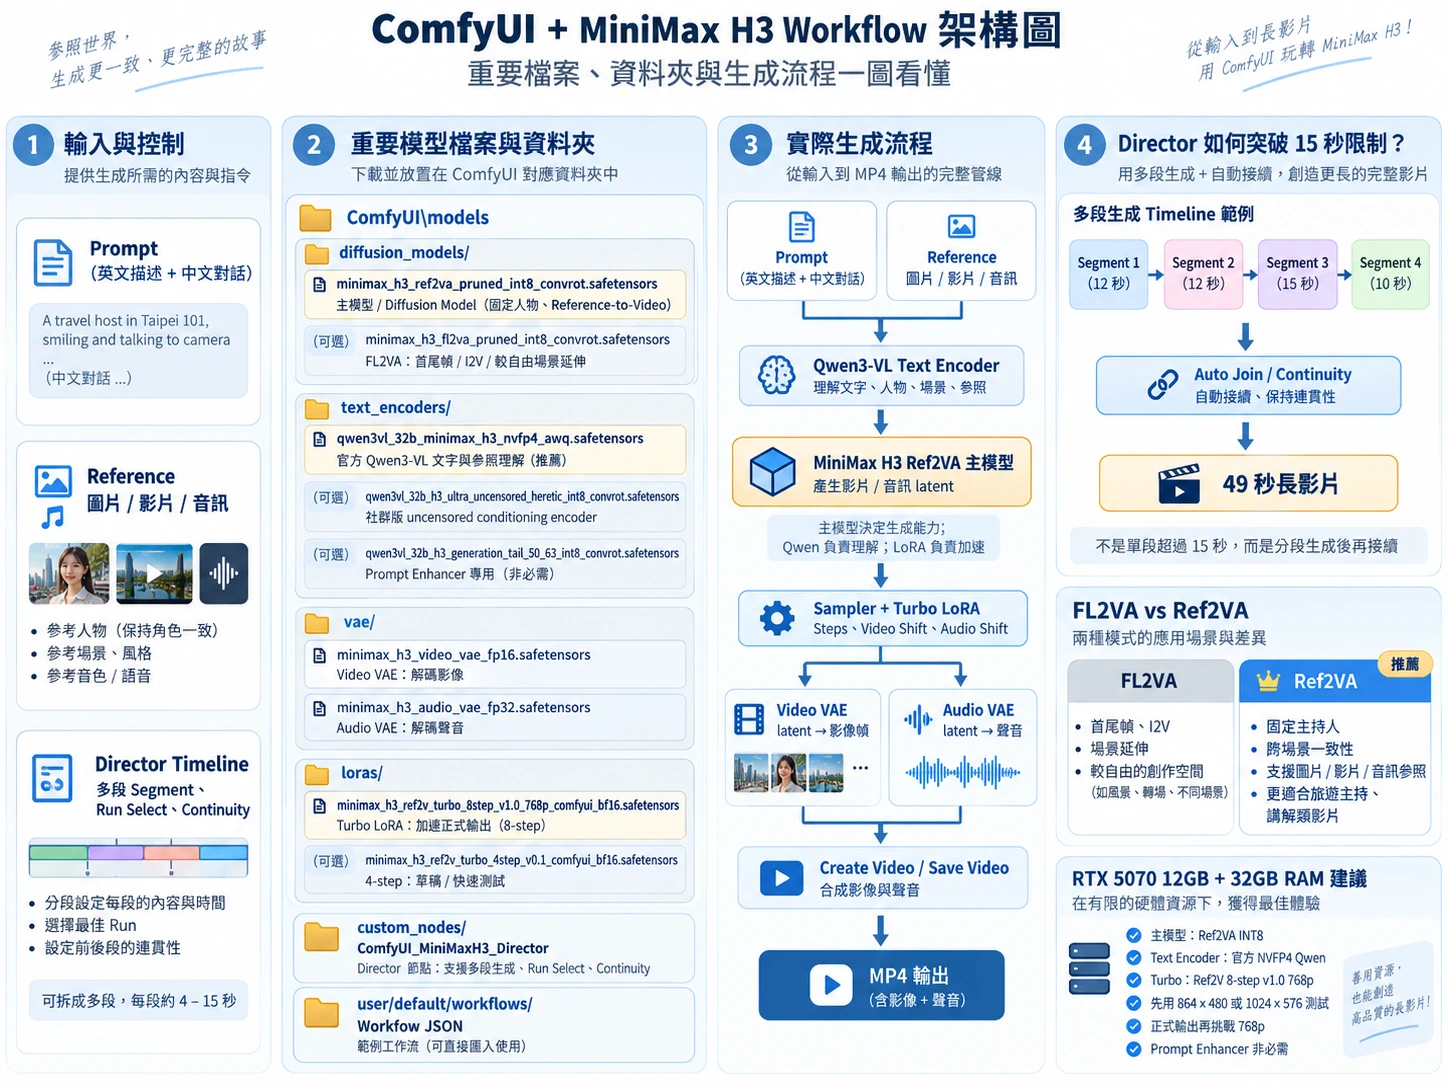
ComfyUI 可以把它想成「AI 模型的節點式工作台」。不像傳統軟體把所有設定塞在一個視窗裡,ComfyUI 把每個工作拆成一個節點:載入主模型、載入文字編碼器、讀取圖片、建立 Prompt、Sampling、VAE 解碼、合成音訊、輸出 MP4,再用線把資料流接起來。
主模型(UNET / Diffusion Model)
          ↓
文字與參照理解(CLIP / Text Encoder)
          ↓
MiniMax H3 conditioning / latent
          ↓
Sampler
          ↓
Video VAE ──→ 影像
Audio VAE ──→ 聲音
          ↓
輸出 MP4
而 Workflow 就是這張「節點接線圖」的設定檔。ComfyUI 可以把節點、參數、連線與模型名稱記錄成 JSON。換句話說,Workflow 不是模型本身;它比較像一份可以重複執行的製作流程。
這也解釋為什麼網路上會看到很多「MiniMax H3 Workflow」:有人做最精簡版,有人做多段 Director,有人加 Prompt Enhancer,有人加第二次 Refine、Upscale 或 Turbo LoRA。真正的 H3 主模型可能一樣,但工作方式差很多。
↑ 回到目錄
九、MiniMax H3 在紅什麼?
MiniMax H3 的重點不是只有畫面變漂亮,而是把原本分散的任務放進同一套多模態生成架構。官方模型分成兩個最重要的路徑:
| 模型路徑 | 主要能力 | 適合情境 |
|---|---|---|
FL2VA |
文字、首幀、尾幀;可做 T2V、I2V、First/Last Frame | 畫面延伸、場景轉換、首尾控制、較自由的運鏡 |
Ref2VA |
多模態 Reference:圖片、影片、音訊 | 固定人物、固定服裝、聲音、動作或風格的跨片段一致性 |
官方 Ref2VA 最多可接受多張參考圖、參考影片與參考音訊,Prompt 內用 <Picture 1>、<Video 1>、<Audio 1> 指定各個參照的角色。這讓「同一位主持人連拍多個場景」變得比單純用第一張圖硬撐 60 秒更實際。
一個重要觀念:本機開放權重的主力輸出是 768p 級別;官方提到的 2K 是 H3-Regenerate-2K 路徑。做本機 Workflow 時,不要把「模型最高可到 2K」直接理解成 RTX 5070 可以舒服地原生跑 2K。
↑ 回到目錄
十、UNET / Diffusion Model:FL2VA、Ref2VA、bf16 與 INT8 差在哪?W4A8 怎麼選?
在 H3 Workflow 裡,最核心的「影片生成主模型」就是 Diffusion Model,很多人習慣口語上仍叫它 UNET。最容易混淆的是 FL2VA 和 Ref2VA 不是精度版本,而是不同任務路徑。
| 檔案 | 大約大小 | 特色 | 我會用在哪裡 |
|---|---|---|---|
minimax_h3_fl2va_pruned_int8_convrot.safetensors |
約 21 GB | ComfyUI 官方優化版;T2V / I2V / 首尾幀 | 景觀、運鏡、首尾畫面控制 |
minimax_h3_ref2va_pruned_int8_convrot.safetensors |
約 21 GB | ComfyUI 官方優化版;Reference-to-Video | 固定真人主持人、多模態 Reference |
NVFP4minimax_h3_fl2va_pruned_nvfp4.safetensors |
約 12.5 GB | NVFP4 低位元量化(社群版,非 Comfy-Org 官方檔);理論上可加速,但快動作時畫質會變差 | 不大推薦;畫面動作少的場景可自行測試 |
NVFP4minimax_h3_ref2va_pruned_nvfp4.safetensors |
約 12.5 GB | NVFP4 低位元量化(社群版,非 Comfy-Org 官方檔);理論上可加速,但快動作時畫質會變差 | 不大推薦;人物大動作、運鏡快時畫質明顯變差 |
minimax_h3_fl2va_pruned_w4a8_mixed.safetensors |
約 12 GB 級 | 實驗性 W4A8,顯著降低權重體積 | 12GB VRAM 機器的進階省記憶體方案 |
minimax_h3_ref2va_pruned_w4a8_mixed.safetensors |
約 12 GB 級 | Ref2VA 的 W4A8 版本 | RTX 5070 + 固定人物 Reference |
關於 NVFP4(表中黃底列):NVFP4 是更低位元的量化格式,檔案只有約 12.5 GB,理論上可以加速。但實測在快動作(人物大幅移動、快速運鏡)時畫質會變差,所以我不大推薦,仍以官方 INT8 為主。這兩個檔案目前是社群上傳,不在 Comfy-Org 官方 Repo(例如可在 Hugging Face 的 lilcheaty/MiniMax-H3-NVFP4 找到),放進 diffusion_models 的方式相同。注意不要跟第十一章的 qwen3vl_32b_minimax_h3_nvfp4_awq 搞混:那是文字編碼器,我仍然推薦使用。
官方 INT8 ConvRot 比較省事,標準 Loader 就能走;W4A8 的優點是模型小很多,但它屬於實驗性格式,依你下載的來源可能需要特定 W4A8 Loader / comfy-kitchen build。不要看到檔案只有 12 GB 就直接拿標準 Load Diffusion Model 硬讀。
RTX 5070 12GB 的選擇:我目前實際使用的是官方 minimax_h3_ref2va_pruned_int8_convrot.safetensors,搭配 ComfyUI 動態 offload。相較 W4A8,INT8 檔案較大、搬運量也較高,但 Loader 相容性與整體穩定性較省事;對我目前 RTX 5070 12GB + 32GB RAM 的環境,這是實際採用的主模型。W4A8 則保留作為進一步節省記憶體的實驗性選項。
官方 bf16 與 int8_convrot:大小、效果差在哪?為什麼選 INT8?
Comfy-Org 官方 Repo 對同一個任務路徑(例如 Ref2VA)提供好幾種精度版本。bf16 是接近原始精度的版本,INT8 是把權重壓成 8 位元整數的量化版本(int8_convrot 是官方採用的做法)。另外還分「pruned」與完整版:官方說明 pruned 版把約佔 40% 參數的 modulation 權重,換成功能等價的查表,記憶體大幅縮小、輸出品質不受影響,而且官方範本載入的都是 pruned 版。
| 檔案(以 Ref2VA 為例) | 大小 | 說明 |
|---|---|---|
minimax_h3_ref2va_bf16.safetensors |
約 66.3 GB | 完整版、bf16,最大,本機幾乎不實用 |
minimax_h3_ref2va_pruned_bf16.safetensors |
約 40.2 GB | pruned、bf16;需要較多 VRAM / RAM |
minimax_h3_ref2va_int8_convrot.safetensors |
約 34.0 GB | 完整版、INT8 |
minimax_h3_ref2va_pruned_int8_convrot.safetensors |
約 21.0 GB | 本文使用:pruned + INT8,也是官方範本採用的版本 |
minimax_h3_ref2va_pruned_fp8_scaled.safetensors |
約 21.0 GB | 官方說明:只有用不了 int8_convrot 時才用 |
minimax_h3_ref2va_pruned_w6a8.safetensors |
約 16.0 GB | 更小的官方量化版 |
大小以 Comfy-Org / MiniMax-H3 的檔案列表為準(FL2VA 版本大小相同)。官方 ComfyUI 部落格也提到,全精度的整體記憶體約 123.6 GB,用最小版本可降到 42.5 GB。
效果差在哪?pruned INT8 只有 bf16 的約一半大小,官方稱這個 INT8 量化是「accurate」。不過官方沒有公開 bf16 與 int8 的逐項畫質對照數據,所以不能下「完全看不出差別」的結論。肯定的差別在資源上:bf16 檔案大一倍,能常駐顯卡的比例更低,每次都要在 VRAM 與 RAM 之間搬更多資料;加上約 15.7 GB 的 Text Encoder,32GB RAM 會更吃緊,更容易用到 Page File。
為什麼本文選 INT8?
- 官方 Repo 說明:能使用 PyTorch cu130 時,Diffusion Model 優先選
int8_convrot。 - 官方範本載入的就是
pruned_int8_convrot,Workflow 與 Turbo LoRA 的相容性最有保障。 - RTX 5070 12GB + 32GB RAM 要靠 offload,檔案小一半,搬運量與 RAM 壓力都低很多。
什麼時候考慮 bf16?RAM 夠大(例如 64GB 以上)、VRAM 也夠,想自己做畫質對照時;或需要 Comfy Kitchen attention 的時候。官方文件指出,int8_convrot 檔案不支援 Comfy Kitchen attention(取樣會報對齊錯誤),要用它得換 bf16 檔案。另外,若搭配 SageAttention 時片尾出現畫面變形(morphing)或畫面文字亂掉,官方認為多半是 INT8 attention 造成的,這是 attention 的量化,與權重量化是兩件事;本文不建議一開始就裝 SageAttention(見第十九章)。
十一、CLIP / Text Encoder:Qwen3-VL 該選哪一顆?
MiniMax H3 的文字與多模態理解使用 Qwen3-VL 系列。這一層(Text Encoder,ComfyUI 裡常口語叫它 CLIP)會讀你的 Prompt,也會看懂你放進去的 Reference 圖片與影片,再把結果交給後面的 H3 主模型。它不是拿來「畫影片」的,但如果它沒理解你要誰做什麼,後面的主模型也救不回來。
先講結論:第一次安裝、日常使用,只要第四章下載的 qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors(官方版,約 15.7 GB)就夠了,下面另外兩顆都是選用。這類檔案一律放在 models\text_encoders\,載入節點的 type 選 minimax。
| 檔案 | 大小 | 角色 | 是否必需 | 5070 + 32GB RAM 建議 |
|---|---|---|---|---|
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
約 15.7 GB | ComfyUI 官方 H3 Text Encoder | 是(二選一) | 首選;目前最實際 |
qwen3vl_32b_h3_ultra_uncensored_heretic_int8_convrot.safetensors |
約 24.55 GiB | 社群版 uncensored(俗稱「越獄」)Text Encoder,取代官方版使用 | 選用(二選一) | 想降低 Prompt 被前置語言層拒絕/弱化時才用;32GB RAM 壓力明顯較大 |
qwen3vl_32b_h3_generation_tail_50_63_int8_convrot.safetensors |
約 7.6 GB | 補上後段語言層,讓 Prompt Enhancer 能「改寫文字」 | 選用 | 不用 Prompt Enhancer 就不要載 |
注意:前兩顆是「二選一」,Workflow 裡一次只會載入其中一顆,不是兩顆都放進去就會一起用。第三顆 generation tail 不能單獨使用,也不能取代前兩顆。
Ultra Uncensored Heretic 到底「解禁」了什麼?
這顆可以理解成「語言/Prompt 理解端的解禁版」:它是由經過 abliteration/heretic 處理、專門降低拒答傾向的 Qwen3-VL-32B 衍生而來,社群上常俗稱「越獄模型」。但它不是 MiniMax H3 影片主模型本身的解禁版。真正生成影片的仍然是 minimax_h3_fl2va... 或 minimax_h3_ref2va... 這類 Diffusion Model;Qwen3-VL 只負責前面的「理解」。
實際差別是:當 Prompt 含有一般 Instruct 模型可能自行拒絕、淡化、改寫或迴避的描述時,這個版本傾向更直接地把原始語意編碼給 H3。它改變的是「模型怎麼理解你的要求」,並不會替 H3 憑空增加新的生成能力。最後畫面能不能做出來、做到什麼程度,仍取決於 H3 主模型、Reference、Sampling、LoRA 與 Workflow。
代價是記憶體:它約 24.55 GiB,比官方 NVFP4 版多出將近 9 GB。以 RTX 5070 12GB + 32GB RAM 來說,我仍把官方 NVFP4 當成日常首選,Ultra Heretic 視 Prompt 需求再切換。模型說明:Qwen3-VL-32B Ultra Uncensored Heretic — H3 ComfyUI INT8 ConvRot。
generation_tail_50_63 是什麼?
H3 只需要 Qwen3-VL 前半段的輸出,所以上面兩顆 Text Encoder 只包含 token embedding、language layers 0–49 與完整的 vision tower(H3 取用第 49 層之後的 hidden state)。後面的 language layers 50–63、final norm 與 LM head 被另外拆成 generation_tail_50_63。
它只有一個用途:讓相容的 Prompt Enhancer 把 Qwen 當成「文字生成器」來改寫 Prompt。所以它不是第三種完整的 CLIP,也無法自己取代前面的 Text Encoder。如果你已經用 ChatGPT、Claude 或其他 AI 把每一段完整的 H3 Prompt 寫好,我反而建議把 Prompt Enhancer 關掉、也不要載這顆:15 秒很短,Prompt 已經包含鏡頭、動作、台詞與音效時,再二次擴寫很容易把一段塞得太滿,還白白多吃約 7.6 GB。
怎麼選?
| 你的情況 | 建議 |
|---|---|
| 第一次使用、一般 H3 影片生成、RAM 只有 32GB | 官方 qwen3vl_32b_minimax_h3_nvfp4_awq,不需要其他任何 Qwen 檔案 |
| 希望 Prompt 不容易被前置語言模型弱化或迴避,且能接受較大的記憶體壓力 | 換成 ultra_uncensored_heretic_int8_convrot(取代官方版,不是加裝) |
| 已經用外部 AI 寫好完整 Prompt | 不需要 generation tail;把 Prompt 直接送進 H3 即可 |
最後一個容易混淆的地方:nvfp4 出現在兩種檔案裡。qwen3vl_..._nvfp4_awq 是「文字編碼器」,我推薦使用;第十章表格裡黃底的 minimax_h3_..._pruned_nvfp4 是「主模型」,我不大推薦。兩者放的資料夾也不同(text_encoders 與 diffusion_models)。
十二、Video VAE 與 Audio VAE:兩顆都要
| 檔案 | 大小 | 功能 |
|---|---|---|
minimax_h3_video_vae_fp16.safetensors |
約 5.21 GB | 把影片 latent 解碼成實際影像 |
minimax_h3_audio_vae_fp32.safetensors |
約 605 MB | 把音訊 latent 解碼成 H3 原生聲音 |
這兩顆不是「畫質版 vs 音質版」二選一。H3 是影音共同生成,所以要輸出有聲影片時兩顆都要接上。Video VAE 也不是主要用來保持人物臉部一致性;人物身份仍主要由 Ref2VA、Reference、Prompt 與 Sampling 共同決定。
↑ 回到目錄
十三、Turbo LoRA:為什麼要加速、代價是什麼?本文使用 8-step Ref2V/FL2V Turbo
LoRA 在這裡不是拿來換畫風,而是用來加速 MiniMax H3 的 Sampling。本文分享的兩份 Workflow,R2V 採用 Ref2V 8-step Turbo,FL2V(首尾幀)採用 FL2V 8-step Turbo,兩者都是 8 步。下面的表格以 R2V 為例,FL2V 的對應檔案在表格後面。
| 項目 | 本文實際設定 | 用途 |
|---|---|---|
| 主模型 | minimax_h3_ref2va_pruned_int8_convrot.safetensors |
Ref2VA / Reference-to-Video 主模型 |
| Turbo LoRA | minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors |
Ref2V 8-step Turbo,加速正式生成 |
| LoRA strength | 1.0 |
完整套用 Turbo LoRA |
| Steps | 8 |
與 8-step Turbo 對應 |
最重要的配對原則:Ref2VA 主模型搭配 Ref2V Turbo,FL2VA 主模型搭配 FL2V Turbo;本文分享版固定使用 8-step v1.0,Director 的 steps 也設定為 8。不要只改 Steps 而沒有確認 LoRA,也不要把 FL2V Turbo 套到 Ref2VA。
本文實際使用的 Turbo 檔案是:
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors這顆 LoRA 放在:
ComfyUI\models\loras\首尾幀(FL2V)模式的加速 LoRA:主模型換成 minimax_h3_fl2va_pruned_int8_convrot.safetensors 時,加速 LoRA 也要換成 FL2V 版,檔案同樣放進 ComfyUI\models\loras\,strength 1.0、Steps 8:
| 模式 | 加速 LoRA 檔名 | 大小 | 下載 |
|---|---|---|---|
| R2V(參考圖) | minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors |
約 1.96 GB | lightx2v / Minimax-h3-Turbo |
| FL2V(首尾幀) | minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors |
約 1.96 GB | lightx2v / Minimax-h3-Turbo |
為什麼要加速 LoRA?大小、速度與代價
它是什麼?Turbo LoRA 是「蒸餾(distillation)」出來的加速補丁:不換主模型,而是在主模型上疊一個小檔,讓模型用較少的 Sampling 步數就能得到接近的結果。ComfyUI 版檔案約 1.96 GB,相對於 21 GB 的主模型很小。官方範本預設不啟用加速(Enable Lightning LoRA 關閉)時跑 20 步,打開後 T2V / I2V 範本降為 8 步,使用 Reference 加速 LoRA 的範本(Reference to Video 等)降為 4 步。
| 項目 | 不用加速(官方 base) | 8-step Turbo(本文) |
|---|---|---|
| Steps | 20(官方預設) | 8 |
| 額外檔案 | 不需要 | 約 1.96 GB LoRA(ComfyUI 版) |
| 速度 | 基準 | Sampling 步數少約 6 成;總時間還包含文字編碼、offload 與 VAE 解碼,不會剛好快 2.5 倍 |
| Reference 與臉 | 官方建議需要緊貼參考圖時,關閉加速、跑 20 步 | 步數少時,Reference 作用的機會減少,官方指出人物姿態或臉角度可能隨片長漸漸偏離 |
| 語音 | 較穩 | 官方指出 8 步時,語音與聲音音色是最弱的部分,12 步以上才算堪用 |
表中「Reference 與臉」和「語音」是官方文件的說法,主要針對官方範本的步數設定;本文使用的是 LightX2V 的 Ref2V 8-step v1.0,不是 4-step 版本,實際偏離程度需要自己的素材驗證。
為什麼本文仍然用 Turbo?RTX 5070 12GB 要靠 offload,每多一步都很花時間;固定主持人的口播片段又會一段一段重新帶 Reference(見第十六章),我選擇用速度換掉一部分穩定度。如果你發現人物逐漸不像、或台詞聲音不清楚,可以改成:把 Turbo LoRA 關掉(或在 Workflow 中 bypass),Steps 回到 20,仍然偏離再試 25;時間會明顯拉長。
配對提醒:LoRA 要對應它蒸餾時的 checkpoint 版本。官方說明 Turbo LoRA 不含 adaln 權重,pruned 與完整版主模型都能載入;本文用的 pruned INT8 主模型可直接搭配 Ref2V Turbo。Steps 要與 LoRA 一起改:開 Turbo 就用 8,關掉 Turbo 才用 20。
十四、Director 有什麼特色?Workflow 使用重點
MiniMax H3 Director 是做什麼的?
(安裝方式請看第三章,Workflow 載入方式請看第六章。)一般 H3 Workflow 是「一段影片一張 graph」。Director 則把 H3 包成一個多段 Timeline 主控台:你可以新增 Clip、刪除 Clip、拖曳順序、指定每段秒數、選擇 T2V / I2V / FL2V / R2V,並決定片段之間要不要連續。
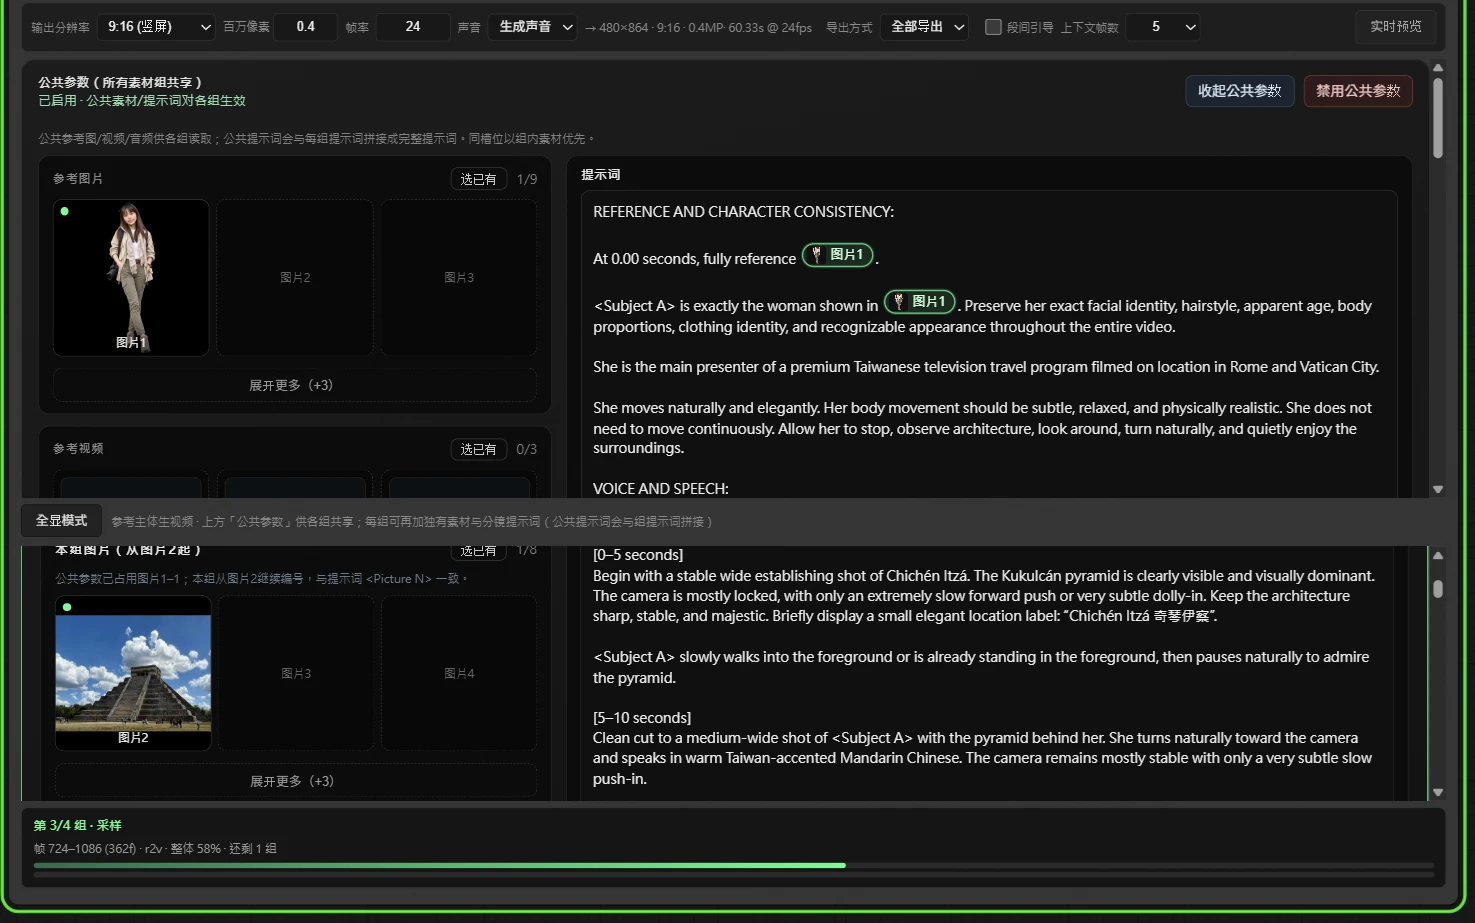
公開版 Director 目前支援多段 Timeline、FL2V、R2V、V2V / RV2V、Reference Groups、原生 Stereo Audio、Run Select、Refine / Upscale 與 Segment Continuity。以 Reference 模式來說,Common Params 可以放共用的人物 Reference,個別段落再額外加入圖片、影片或音訊;每段 Prompt 可以各自獨立。
我分享的「加速版修正」Workflow 使用重點
文末分享的 Workflow 主要不是要把 H3 改成另一個模型,而是把「模型 Loader + Turbo LoRA + Director Timeline + 影音輸出」整理成適合多段生成的工作方式。實際使用時,我會把它拆成三層理解:
| 層級 | 你主要要改什麼 | 通常不用一直動的東西 |
|---|---|---|
| 模型層 | FL2VA / Ref2VA、Turbo LoRA | Video / Audio VAE、Qwen Encoder |
| 主控台層 | 解析度、Steps、Shift、Segment Continuity、Run Select | 節點接線本身 |
| 內容層 | 每一段的 Reference、Prompt、Dialogue、Camera、Soundscape | 模型 Loader |
這樣做的好處是:要改劇情時,不用重新拉整張 ComfyUI Graph;只需要在 Director Timeline 裡增減片段,或讓 AI 重新產生其中一段 Prompt。
↑ 回到目錄
參考圖生影片:Ref image size 用 match,不要直接用 max
依我這次本機 R2V/Ref2VA 製作的觀察,參考圖尺寸選項會大幅影響生成時間。日常試片與多段短劇,我會把每一個 Segment 的 Ref image size 設成 match,不要直接用 max。排查「明明一樣的片長與 Steps,這次卻特別慢」時,這是應該優先檢查的設定之一。
match 是讓參考圖的處理尺寸配合當前生成畫布;max 則走節點所設定的較大參考尺寸策略。實際縮放方式與上限依 Director/參考生成節點版本而定,不是把圖片硬拉伸成影片比例,也不等於一定保留原圖最高解析度。當 max 讓模型處理的參考圖更大時,參考編碼與後續參考條件運算的負擔也可能增加;多張 Reference、多段生成與顯存吃緊時,時間差會更明顯。這是本機製作心得,沒有在這裡宣稱固定加速倍數,也不是所有圖片都一定有相同差距。
| 設定 | 這篇的使用原則 | 注意 |
|---|---|---|
match |
R2V 日常預設;全片每一段都確認 | 控制參考圖處理負擔,先跑出毛片再驗收臉部與細節 |
max |
不直接用作整部片預設 | 只有刻意比較較大參考尺寸時,才在少量片段測試時間、顯存與畫面改善 |
主控台的 Ref Max Size 數字,和每段的 Ref image size = match/max 是不同設定。只看到 Ref Max Size = 864,不能據此判斷所有段落已經是 match;也不要把輸出影片解析度當成參考圖處理尺寸。二採輸出 720p,不代表一採所有參考圖都必須用 max。
- 先確認全局/Output 的參考圖尺寸為
match。 - 逐段檢查 Segment 的尺寸選項,避免部分段落仍覆寫成
max。 - 修改 JSON 時,同步 Director 主時間軸、具名時間軸與 R2V 工作區副本;重新載入後,在主控台再確認一次。
- 比較速度時,保持同一段 Prompt、Seed、片長、參考圖數量與採樣設定;第一次模型載入和後續暖機的耗時分開記錄。
R2V / Ref2VA 日常設定:
Output / 全局參考圖尺寸 = match
每個 Segment 的 Ref image size = match

JSON 欄位(本文使用的 Director 版本):
output.refImageSize = "match"
segments[*].refImageSize = "match"
batchWorkspaces.r2v.segments[*].refImageSize = "match"
以上 JSON 欄位屬於本文使用的 Director 儲存結構,不是 MiniMax H3 官方 Prompt 語法。參考原圖仍保留清楚、乾淨的版本,match 調整的是進入生成流程時的處理方式,不需要把唯一的原始照片覆寫成低解析度。
十五、Director 的 Sampling 設定:Steps、Sampler、Scheduler、Shift 是什麼?
Director 的進階 Sampling 區看起來很複雜,但本文分享的 Workflow 已經把主要參數配好。除非更換主模型、Turbo LoRA,或刻意做參數比較,日常使用時通常不需要一直修改。
| 設定 | 本文 Workflow 實際值 | 作用 | 平常是否要改 |
|---|---|---|---|
Steps |
8 |
Sampling 的主要迭代次數,也就是 H3 主模型反覆更新 Video / Audio latent 的輪數 | 通常不改;本文使用 8-step Turbo,因此維持 8 |
Sampler |
res_multistep |
決定每一個 Sampling step 如何利用模型預測來更新 latent | 通常不改 |
Scheduler |
simple |
決定各個 step 對應的 noise / sigma 分布 | 通常不改 |
Shift Video |
12 |
調整 Video latent 的 Sampling / noise schedule 分布 | 通常不改 |
Shift Audio |
3 |
調整 Audio latent 的 Sampling / noise schedule 分布 | 通常不改 |
Steps:最重要,也最容易被誤解
Steps 不是影片秒數,也不是 FPS。它代表一次影片生成過程中,Sampler 讓 H3 主模型進行幾輪主要 Sampling 更新。本文 Workflow 使用 steps = 8,也就是模型會依照 Scheduler 安排的取樣位置,反覆更新 latent 八次,再交給 Video VAE 與 Audio VAE 解碼成真正的影片與聲音。
一團雜訊
        ↓
Step 1 開始出現大概構圖
        ↓
Step 2 人物逐漸形成
        ↓
Step 3 動作、背景更明確
        ↓
Step 4
        ↓
Step 5
        ↓
Step 6
        ↓
Step 7
        ↓
Step 8
        ↓
Video / Audio latent
        ↓
VAE Decode
        ↓
影片 + 聲音
Steps 會直接影響生成時間。其他條件相近時,Step 數越高,主 Sampling 計算通常越久;但整體 Workflow 還包含 Qwen3-VL 編碼、Reference 處理、模型在 RAM / VRAM 之間的 offload,以及 Video / Audio VAE 解碼,因此總時間不會單純只由 Steps 決定。
本文不建議把 8 再任意拉高。目前 R2V Workflow 已經搭配 minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors,FL2V Workflow 則搭配 minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors。Turbo LoRA 與 Steps 應視為同一組設定;顯卡換得更快,通常只是讓相同 8 steps 跑得更快,並不代表應該自動增加 Steps。
Sampler:每一步怎麼走
H3 在每個 Sampling step 都會預測目前 latent 應該往哪個方向修正;Sampler 則決定如何利用這個預測得到下一步。本文分享 Workflow 的實際設定是 res_multistep,因此文章與下載的 JSON 都以這個值為準。
Scheduler:這 8 步分布在哪些 noise level
如果把 Sampler 理解成「每一步怎麼走」,那 Scheduler 就是「每一步安排在哪個 noise / sigma 位置」。本文使用 simple。
Sampler   = 每一步如何更新 latent
Scheduler = 這些 step 如何分布在 noise / sigma schedule 上
Shift Video / Shift Audio
Shift Video 與 Shift Audio 不是影片位移、也不是聲音延遲幾秒,而是分別調整 Video latent 與 Audio latent 的 Sampling schedule。MiniMax H3 是影音共同生成,因此影片與音訊有各自的 shift 設定。
本文分享 Workflow 實際使用:
Steps       = 8
Sampler     = res_multistep
Scheduler   = simple
Shift Video = 12
Shift Audio = 3實務上最重要的結論:這五個值在本文 Workflow 中是一整組已經配好的 Sampling 設定。一般使用者真正比較常調整的是解析度、片長、Reference、Prompt、Segment Continuity 與要跑哪些 Segment;Sampling 參數本身反而不用一直動。
↑ 回到目錄
十六、如何突破 MiniMax H3 單次 15 秒限制?FL2VA vs Ref2VA 怎麼用?
先講清楚:Director 並沒有把 MiniMax H3 的「單次生成上限」破解掉。H3 每個 Sample 仍然是最多約 15 秒。所謂突破 15 秒,是在 Workflow 層把長影片拆成多個合法片段,分段生成後再接起來。
Segment 1:12 秒
       ↓ 取前一段尾端作為 continuity context
Segment 2:12 秒
       ↓
Segment 3:15 秒
       ↓
Segment 4:10 秒
       ↓
Director 合併輸出 → 49 秒影片
Director 的 Segment Continuity 可以把上一段生成尾端的動作/影音 context 帶進下一段,再把重複的 prefix trim 掉,因此視覺上比單純「四支 MP4 硬接」自然很多。公開版 Director 也允許自己增減 Clip,所以影片不必固定四段;兩段、六段、十段都可以,真正限制會變成你的生成時間與一致性,而不是 Timeline 長度。
長影片要用 FL2VA 還是 Ref2VA?
| 情境 | 較適合 | 原因 |
|---|---|---|
| 同一場景連續走動,重視上一段尾幀接下一段 | FL2VA | 首幀/尾幀控制直覺,畫面延伸自由度高 |
| 同一個真人主持人跨不同城市/不同場景 | Ref2VA | 每段都可以重新用人物 Reference 鎖身份 |
| 要同時參照人物、聲音、某種運鏡影片 | Ref2VA | 原生就是 Omni-reference 路徑 |
| 刻意硬切到全新場景 | T2V / 關閉 Continuity | 不要讓上一段尾端限制新鏡頭 |
以「同一位旅遊節目主持人,在羅馬連續四段介紹不同景點」為例,我會偏向 Ref2VA:每個 Segment 都共用同一張主持人 Reference,再讓 Director 維持必要的 continuity。這比只靠第一段尾幀一路傳下去,更能降低人物臉部隨片段慢慢漂移。
↑ 回到目錄
十七、最實用的一招:讓 AI 幫每一段寫 MiniMax H3 Prompt
Director 最大的價值之一,是「分鏡」和「模型」分開。你不需要自己在 ComfyUI 裡一句一句想台詞;可以先把整支影片的目的交給 ChatGPT 或其他 AI,請它規劃 N 段,再把每段 Prompt 貼進 Timeline。
我現在會用下面這種指令:
你是 MiniMax H3 Director 的分鏡規劃助手。
請把主題拆成 4 個 Segment,每段 10–15 秒。
同一位主持人必須維持人物一致性,Reference 使用 <Picture 1>。
每段只安排 1 個主要人物動作與 1–2 個主要運鏡,避免 15 秒內過度擁擠。
對話使用自然台灣華語,台詞長度必須能在該段時間內自然說完。
Prompt 本體用英文,但對話保留繁體中文。
每段輸出:
1. duration
2. integrated_multimodal_description
3. overall_soundscape
4. non_diegetic_music
5. continuity note
若這一段是新的硬切場景,也請標註 hard cut。
MiniMax H3 的 Prompt 可以把畫面、台詞與聲音一起描述。例如:
integrated_multimodal_description:
At 0.00 seconds, fully reference <Picture 1>.
The same female travel presenter walks slowly through a Roman street,
then stops and looks up at the Pantheon. Begin with a side tracking shot,
then reveal the building around the corner.
She says: <d>[Chinese] 我很喜歡羅馬的一點,就是不用特別找景點,走在巷子裡就到處都是歷史。</d>
overall_soundscape:
Natural Rome street ambience, footsteps, distant conversation,
clear synchronized Mandarin dialogue.
non_diegetic_music:
Soft elegant European travel-documentary music, low volume.實務心得:每段 15 秒不要塞四個場景、五個動作、三句長台詞。長影片的正確做法不是把每段壓到極限,而是多加一個 Segment。
↑ 回到目錄
十八、人物臉部一致性怎麼改善?多角度 Reference、構圖、解析度與後製
MiniMax H3 的 Ref2VA 很適合固定真人主持人,但它本質上仍是 Reference conditioning,不是逐幀硬鎖臉。實際生成 10–15 秒口播影片時,如果人物轉頭、走動、嘴型變化很多,或鏡頭拉得太遠,臉部仍可能逐漸變軟、變糊或出現 identity drift。這時候最有效的改善方式,通常不是先把 Steps 往上加,而是先把 Reference 品質、人物在畫面中的比例、解析度與單段動作複雜度處理好。
1. 不要只放一張正面照:用 3 張不同角度 Reference
如果是固定旅遊節目主持人,我會準備三張同一人物的乾淨參考圖,放進 Common / Global References:
| Reference | 建議角度 | 主要用途 |
|---|---|---|
Reference 1 |
正面全身 | 建立整體身形、服裝、髮型與正面臉部基準 |
Reference 2 |
微側 30–45° 全身 | 補足轉頭、側臉與行走鏡頭時的五官資訊 |
Reference 3 |
另一側 30–45°,或清楚半身照 | 補另一側輪廓;半身照也能提供更多眼睛、鼻子、嘴型細節 |
三張圖最好維持同一髮型、相近妝感、接近的年齡感與服裝風格。臉部要清楚,不要被頭髮、墨鏡或帽沿遮住,光線也盡量均勻。對主持人類型影片來說,其中一張使用較近的半身 Reference,通常比三張都是遠距全身照更有價值,因為模型可以取得更多真正的臉部像素。
2. Reference 的臉要亮、乾淨、角度互補
- 臉部正確曝光,眼睛、鼻翼、嘴角與下顎輪廓清楚。
- 避免過強側光、逆光、墨鏡、帽沿遮臉。
- 正面與左右 30–45° 角度互補,不要三張都是幾乎相同姿勢。
- 如果角色設定是瘦高旅遊主持人,三張圖的身形比例也盡量一致。
3. 說話時讓臉佔畫面更多:Medium shot / Medium close-up
影片解析度固定時,人物離鏡頭越遠,臉實際分到的像素就越少。即使整張畫面看起來還不錯,遠景中的臉仍可能只有很小一塊,因此 H3 很難在每一幀都維持精細五官。
口播、介紹景點:
優先 → medium shot / medium close-up

純看風景:
可以 → wide shot

長時間邊走邊說:
不要讓人物一直維持在很小的遠景比例
尤其是有中文嘴型的主持人片段,嘴巴每一幀都在變,如果同時再做大幅轉頭、快速行走與強烈運鏡,identity drift 會更容易發生。
4. RTX 5070:建議跑 0.4 MP,0.5 MP 就有機會 OOM
本文分享的直式畫布為 480×864,約 0.4 MP,也是我對 RTX 5070 12GB 的建議解析度。實際測試中,升到 544×960(約 0.5 MP)就有機會 OOM(記憶體不足,說明見第十九章)。人臉不夠清楚時,不要先靠加解析度解決。
| 級距 | 9:16 可用尺寸例 | 相對像素量 | RTX 5070 12GB 建議 |
|---|---|---|---|
| 約 0.4 MP | 480×864 |
1.00× | 建議的日常設定:本文 Workflow 的預設值 |
| 約 0.5 MP | 544×960(約 0.52 MP) |
約 1.25–1.30× | 有機會 OOM,不建議;是否爆掉也會受片長、Reference 數量與其他程式佔用影響 |
| 0.6 MP 以上 | 依節點允許尺寸逐步往上 | 約 1.5× 以上 | 更容易 OOM,12GB 不建議 |
人臉糊的時候,我會依這個順序處理:三張互補角度 Reference → 說話時拉近人物(medium shot / medium close-up)→ 縮短每段長度 → 輕度後製,解析度維持 480×864。對目前這套 Ref2VA INT8 + Ref2V Turbo 8-step 而言,這比升解析度或把 Steps 8 硬改成 12 或 16 更穩。
如果真的想試 0.5 MP,先備份 Workflow,在啟動參數加上 --reserve-vram 2.0(見第十九章),並先用短片段測試,做好 OOM 的心理準備。
5. 臉很重要的片段,不一定要硬撐滿 15 秒
15 秒不是一定要用滿。人物需要長時間說話、轉頭、走動時,臉部 drift 會隨時間累積。若某一段特別重視主持人表情與嘴型,可以考慮拆成 8–10 秒,再新增下一個 Segment。Director 本來就適合用多段 Timeline 換取穩定度。
6. Prompt 裡明確寫「身份不變」,但不要只靠 Prompt
Preserve exact facial identity in every frame.
Keep facial proportions, eye shape, nose shape, mouth shape,
jawline, hairstyle, and apparent age unchanged.
Avoid facial drift during head turns and speech.
Favor medium close-up framing while speaking.
Keep the face sharp, well-focused, and evenly lit.
這類文字可以幫助模型理解優先級,但不能取代好的 Reference 與解析度。
7. 生成後還能做什麼?Face consistency 與 Face restoration 要分開看
Face consistency / identity pass 的目的是讓每一幀的臉更接近同一位 Reference;Face restoration 則主要改善已經生成但偏糊的眼睛、鼻子、嘴巴與皮膚細節。兩者不是同一件事。
ComfyUI 常見工具包含 FaceDetailer、ReActor、InstantID、IPAdapter FaceID、PuLID,以及 GFPGAN / CodeFormer 類 restoration。用在影片時要特別注意 temporal consistency:如果每一幀獨立修臉,反而可能產生閃爍。
對有中文口播與嘴型的主持人,不建議一開始就做很重的 face swap 或 restoration,因為可能把表情與 lip sync 修壞。比較穩妥的順序是:
MiniMax H3 Ref2VA 8-step
        ↓
輕度 face consistency / identity correction
        ↓
輕度 face restoration
        ↓
檢查 flicker、嘴型與表情
        ↓
最後再剪輯輸出簡單結論:如果只是覺得臉稍微糊,優先順序建議是:三張互補角度 Reference → 說話時拉近人物 → 維持 0.4 MP(0.5 MP 有機會 OOM)→ 必要時把 15 秒拆短 → 最後才做輕度 face consistency / restoration。
十九、RTX 5070 12GB + 32GB RAM:我會怎麼配?OOM 與 –reserve-vram 怎麼處理?
RTX 5070 不是不能跑 MiniMax H3,但要接受一件事:12GB VRAM 不可能把所有 H3 組件都常駐顯卡。ComfyUI 會動態把權重在 GPU / RAM 之間搬動;真正影響體感的不只是算力,也包括「每次搬多少資料」。因此低位元模型與 Turbo LoRA 很有價值。
本文分享 Workflow 的 Ref2V 組合
| 角色 | 推薦檔案 | 理由 |
|---|---|---|
| 主模型 | minimax_h3_ref2va_pruned_int8_convrot.safetensors |
我目前實際使用的主模型。官方 INT8 ConvRot 相容性與穩定性較好,搭配 ComfyUI 動態 offload,在 RTX 5070 12GB + 32GB RAM 上較省事 |
| Text Encoder | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
日常首選:官方 H3 低記憶體 Qwen,約 15.7 GB;比 24.55 GiB Ultra Uncensored INT8 更適合 32GB RAM。若特定 Prompt 容易被前置語言層弱化,再切換 Ultra Heretic |
| Video VAE | minimax_h3_video_vae_fp16.safetensors |
必要 |
| Audio VAE | minimax_h3_audio_vae_fp32.safetensors |
必要;保留 H3 原生聲音 |
| Turbo LoRA | minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors |
必要;Ref2V 8-step Turbo,strength 1.0,搭配 Steps = 8 |
| Prompt Tail | 不載 | 用外部 AI 寫好 Prompt 時沒有必要多吃約 7 GB |
解析度與片長
本文目前分享的 Workflow 是直式 9:16、約 0.4 MP,實際輸出為 480×864、24 FPS。這是 RTX 5070 12GB 上很實際的起點。RTX 5070 12GB 我建議就停在 0.4 MP:像素量約比 0.5 MP(544×960,約 0.52 MP)少 20–25%,實測 0.5 MP 就有機會 OOM。跨過 12GB VRAM 的臨界點後,要嘛因 RAM / VRAM 搬運而突然變慢,要嘛直接 OOM。想看臉更清楚,請優先用 Reference 與構圖處理(見第十八章)。
Steps
本文分享版 R2V 使用 Ref2V 8-step v1.0 768p Turbo LoRA、FL2V 使用 FL2V 8-step v1.0 Turbo LoRA,因此 Director 的 steps = 8。對 RTX 5070 12GB 而言,若要改善速度,優先考慮解析度、片長、Reference 數量與 VRAM offload,而不是任意把 Steps 改低或改高。
目前分享 Workflow 的完整核心組合
主模型:
minimax_h3_ref2va_pruned_int8_convrot.safetensors

Text Encoder:
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors

Video VAE:
minimax_h3_video_vae_fp16.safetensors

Audio VAE:
minimax_h3_audio_vae_fp32.safetensors

Turbo LoRA:
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors
strength = 1.0

Task:
R2V

Steps       = 8
Sampler     = res_multistep
Scheduler   = simple
Shift Video = 12
Shift Audio = 3

FPS          = 24
畫布         = 480×864(9:16,約 0.4 MP)
Ref Max Size = 864
Ref image size = match(每個 Segment 都確認;不要直接用 max)

Clear VRAM between segments = true
32GB RAM 的現實
官方 21GB UNET + 15.7GB NVFP4 Text Encoder + 5.21GB Video VAE 已經超過 32GB 的「全部同時常駐」空間,更別說 Windows、ComfyUI 與暫存。因此 32GB 可以跑,但動態 offload 和 Page File 幾乎是必然。若 H3 會變成固定工具,升到 64GB RAM 對穩定性與減少磁碟換頁會很有感。
SageAttention 要不要裝?我不會把它列為 RTX 5070 的第一個優化項目。50 系列 Blackwell 的 SageAttention Wheel 與 Python / Torch / CUDA / sm_120 必須完全匹配,裝錯反而讓環境壞掉。先把「Turbo LoRA、NVFP4、INT8 主模型、合理解析度」做好,通常比冒險塞一顆不合版本的 SageAttention 更實際。
低 VRAM/AMD 顯卡:OOM、直接崩潰與 –reserve-vram
OOM 是什麼?OOM 是 Out Of Memory,也就是記憶體不足。生成影片時,模型權重、運算中間結果與最後解碼成影片的畫面,都要放進顯示卡的 VRAM。某一步需要的空間超過可用 VRAM,又沒辦法暫時搬到系統 RAM,就會 OOM。ComfyUI 通常會把當下的節點標成紅色,並顯示類似 OutOfMemoryError 或 CUDA out of memory 的訊息(文字依顯卡與版本而異)。這時 ComfyUI 還活著,改設定後可以再按一次 Queue。
為什麼超過 0.4 MP 就容易 OOM,連 NVIDIA 也一樣?VRAM 主要被三件事吃掉:模型權重(本文 21GB 的主模型本來就比 12GB VRAM 大,必須靠 offload)、隨「像素數 × 影格數」放大的運算空間,以及最後 Video VAE 解碼的瞬間尖峰。15 秒 × 24 FPS 的影格很多,0.5 MP 又比 0.4 MP 多 25–30% 像素,Reference 圖越多通常也佔越多空間。加起來一旦跨過 12GB 的臨界點,狀況就會從「慢一點」直接變成 OOM,而不是慢慢變差。所以 0.4 MP 跑得動、0.5 MP 卻突然爆掉並不奇怪。
| 項目 | OOM | 直接崩潰 |
|---|---|---|
| 畫面表現 | 節點變紅並跳出錯誤訊息,黑色視窗還在 | 黑色視窗突然消失、黑屏或閃爍、驅動程式重置,嚴重時整台電腦當住 |
| 有沒有錯誤訊息 | 有,log 中會看到 out of memory 之類的字樣 | 通常沒有,或 log 在中途就斷掉 |
| 怎麼處理 | 降低解析度、片長與 Reference 數量,再加 --reserve-vram |
先用同樣方法降低 VRAM 壓力,仍崩潰再檢查驅動、ROCm / PyTorch 版本、散熱與電源 |
| 常見於 | NVIDIA、AMD 都會遇到 | 依我的經驗與社群回報,AMD 顯卡較常遇到(這是經驗說明,不是官方統計) |
--reserve-vram 是什麼?這是 ComfyUI 的啟動參數,單位是 GB。官方說明是「保留給作業系統與其他軟體使用的 VRAM」,預設會依作業系統保留一些(實際數值官方未標明)。設得越大,ComfyUI 能用的 VRAM 就越少,會較早把模型搬到 RAM,換來一段留給 Windows、瀏覽器與暫時尖峰的緩衝。代價是搬運變多、速度變慢,等於用速度換穩定。
怎麼加?先把啟動檔(NVIDIA 是 run_nvidia_gpu.bat,AMD 版 Portable 是 run_amd_gpu.bat)複製一份備份,再用記事本開啟,把參數接在 main.py 那一行的最後面。各版本內容略有不同,原則是參數放在同一行尾端:
.\python_embeded\python.exe -s ComfyUI\main.py --windows-standalone-build --reserve-vram 2.0| 設定 | 什麼時候用 | 代價 |
|---|---|---|
--reserve-vram 2.0 |
第一個試。AMD 顯卡崩潰、或 NVIDIA 偶爾 OOM | 較早 offload,速度略慢 |
--reserve-vram 3.0 |
2.0 仍 OOM 或崩潰時 | offload 更多,生成時間更長 |
| 再往上加 | 不建議。留太多 VRAM 會讓模型頻繁搬運,時間暴增 | 此時應先降解析度、片長與 Reference |
一次只改一個數字,並用同一個 Seed、同一段 Prompt 比較是否還會 OOM,以及生成時間增加多少。AMD 顯卡請使用 ComfyUI 官方的 AMD 版 Portable(ComfyUI_windows_portable_amd.7z);本文 Workflow 與實測是以 RTX 5070 為準,AMD 的數值是依官方參數說明設定的起點,請依自己的顯卡再微調。
還有幾個相關參數,官方說明如下,需要時再加:
| 參數 | 作用 | 注意 |
|---|---|---|
--disable-smart-memory |
積極把模型卸到 RAM,釋放 VRAM | 較慢;RAM 不夠時會更常用到 Page File |
--cache-none |
不快取節點結果,降低 RAM / VRAM 佔用 | 每次都要把所有節點重跑一遍 |
--lowvram / --novram |
--novram 是 lowvram 還不夠時才用 |
啟用動態 VRAM 管理時,--lowvram 不會有作用;請先用 --reserve-vram |
遇到 OOM 或崩潰時的處理順序:
- 解析度回到
480×864(0.4 MP)。 - 縮短片段、減少 Reference 數量。
- 加
--reserve-vram 2.0,不行再改3.0。 - 關掉瀏覽器影片、遊戲等也會吃 VRAM 的軟體。
- 仍然直接崩潰:更新顯卡驅動與 ComfyUI(AMD 請用官方 AMD 版)。
二十、常見問題與排查
| 症狀 | 優先檢查 |
|---|---|
| Workflow 打開整排紅色 Missing Nodes | 先更新 ComfyUI(第二章,需 v0.30.0 以上);只有 Director 的節點是紅色,再確認 Director 是否安裝成功(第三章) |
| Director 節點搜尋不到、或啟動時 console 出現 Director 的 import error | 確認 custom_nodes\ComfyUI_MiniMaxH3_Director 資料夾存在;套件要用 ..\..\python_embeded\python.exe -m pip install -r ... 重新安裝(裝到系統 Python 是最常見的錯誤);裝完要重新啟動 ComfyUI |
| 終端機顯示「git 不是內部或外部命令」 | Git 還沒安裝,或剛裝完還沒重開終端機(第一章) |
| 找不到模型、下拉選單是空的 | 檢查 diffusion_models / text_encoders / vae / loras 是否放錯(第五章);放完檔案後要重新整理頁面或重啟 ComfyUI;也確認檔名沒有被瀏覽器加上 (1) 之類的字尾 |
| 載入 Qwen3-VL 時報錯,或文字理解結果異常 | CLIP 載入節點的 type 必須選 minimax |
| Ref2V 卻套 FL2V LoRA | 模型路徑與 LoRA 必須一致 |
| 8-step Turbo 生成結果異常 | 先核對 LoRA 是否與模式對應(R2V 用 Ref2V 8-step v1.0,FL2V 用 FL2V 8-step v1.0),並確認 Steps=8、Sampler=res_multistep、Scheduler=simple、Shift Video=12、Shift Audio=3 |
| 人物每段愈來愈不像 | 長片改 Ref2VA,每段重新帶同一份 Reference;不要只靠尾幀一路傳 |
| 人物臉部偏糊 | 先把口播鏡頭改成 medium shot / medium close-up;RTX 5070 維持 480×864(約 0.4 MP),不要升到 544×960,該尺寸有機會 OOM |
| 人物轉頭後變得不像 | Common References 改用正面 + 左右 30–45° 多角度同人物參考圖;必要時加入清楚半身照補臉部細節 |
| 台詞來不及講完 | 縮短台詞,或多新增一個 Segment,不要硬塞 |
節點變紅,出現 OutOfMemoryError / out of memory(OOM) |
ComfyUI 還活著,這是 VRAM 不夠:先回到 0.4 MP、縮短片段、減少 Reference,再加 --reserve-vram 2.0,見第十九章 |
| 黑色視窗突然消失、黑屏、驅動重置或整台當住(直接崩潰) | 多半也是 VRAM 壓力過大,AMD 顯卡較常見:同樣先降低 VRAM 壓力、加 --reserve-vram 2.0~3.0,仍崩潰再更新驅動與 ComfyUI AMD 版,見第十九章 |
| R2V 相同片長與 Steps,生成時間突然大增 | 先檢查每段 Ref image size 是否仍為 max;日常使用 match,並核對全局與分段覆寫,見第十四章。再檢查模型載入、Reference 數量和 RAM/VRAM 搬運。 |
| 記憶體爆掉、Windows 開始狂讀硬碟 | 降解析度/Ref image size、改低位元模型、關 Prompt Enhancer、確認 Page File |
WinError 10054 |
先看 ComfyUI log 是否 Sampling 仍持續;很多情況只是瀏覽器 WebSocket 斷線,不一定等於模型崩潰 |
參考資料
- MiniMax:Open General Intelligence — MiniMax H3 Is Now Open Source
- MiniMaxAI / MiniMax-H3 Model Card
- Comfy-Org / MiniMax-H3:ComfyUI 模型檔與資料夾配置
- ComfyUI:MiniMax H3 Day-0 Support
- ComfyUI Workflow Templates
- ComfyUI MiniMax H3 Director
- LightX2V / MiniMax-H3 Turbo
- LightX2V:8-step 768p v1.0 release notes
- Kijai / MiniMax-H3-experimental
- Qwen3-VL H3 Ultra Heretic / Generation Tail 說明
- Hugging Face CLI Documentation
這篇文章已有 636 次瀏覽
發佈留言